Lors de l'échange de plans de nettoyage numériques, il est essentiel de savoir quelles données sont réellement reçues par un système de contrôle. Un nom de champ utilisé en double peut évincer des informations dès l'importation d'un fichier JSON. Une validation ultérieure du schéma de l'objet résultant ne voit alors, dans certains cas, que la valeur restante. L'article technique de Jonas Gebäudereinigung explique cette différence à l'aide d'un exemple miniature explicitement fictif.
Un objet JSON contient des entrées nommées. La norme Internet RFC 8259 recommande d'attribuer des noms uniques à l'intérieur d'un objet. Cependant, les noms répétés ne conduisent pas au même résultat selon l'implémentation : certains programmes conservent la dernière paire, d'autres signalent une erreur ou fournissent toutes les paires. Le fait qu'un fichier soit « lisible » ne permet donc pas d'affirmer que toutes les indications initialement contenues ont été préservées.
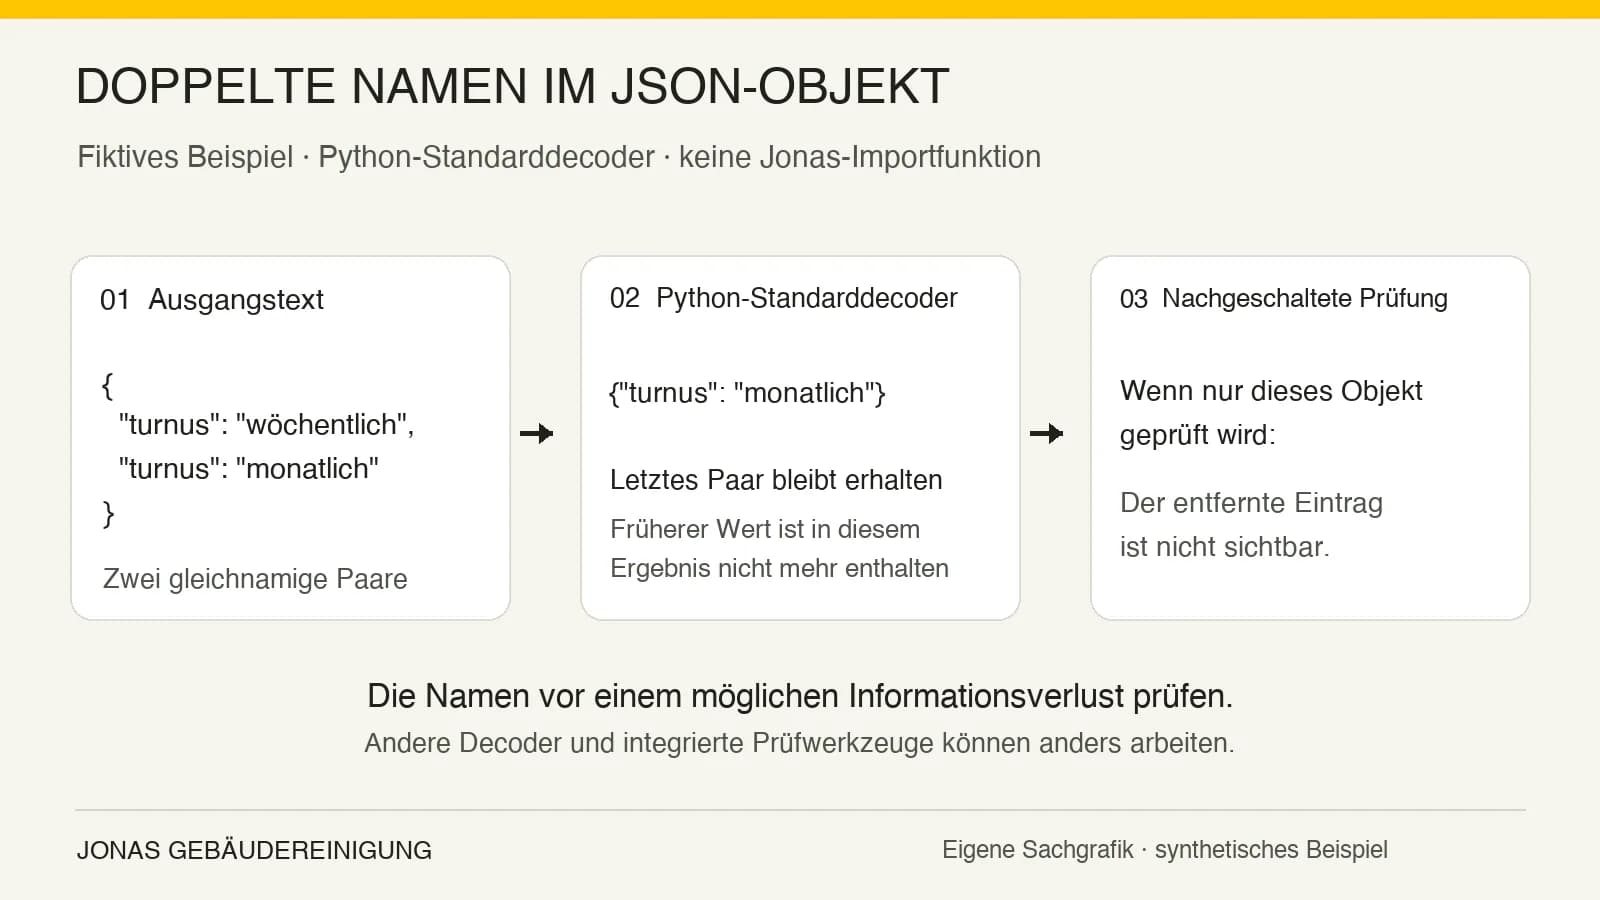
L'exemple miniature est le suivant : {"turnus":"wöchentlich","turnus":"monatlich"}. Il montre deux entrées de même nom dans le même objet. Il ne s'agit pas d'un plan de nettoyage complet ni d'un jeu de données issu du schéma Jonas. Le nom de champ purement fictif sert uniquement à rendre le mécanisme visible. Les deux valeurs figurent dans le texte original ; la signification qui doit prévaloir n'est donc pas tranchée sur le plan technique.
Le décodeur standard de la bibliothèque Python json conserve la dernière paire en cas de telles répétitions. Dans l'essai synthétique réalisé, c'est donc « monatlich » (mensuel) qui a été conservé. Après inversion de l'ordre des paires, « wöchentlich » (hebdomadaire) est resté. Aucune information client n'a été traitée dans ce cadre. Le résultat décrit ce décodeur avec son paramètre par défaut et ne constitue pas une règle générale pour tous les programmes JSON. La double mention initiale ne peut être reconstituée à partir du seul résultat simplifié.
C'est ici que se situe la limite d'une validation de schéma effectuée en aval. Le modèle de données de la spécification JSON Schema 2020-12 représente un objet comme un ensemble de propriétés dans lequel deux propriétés ayant le même nom ne peuvent être représentées. Le comportement en cas de noms en double dans le document source n'y est pas défini. Si un outil examine uniquement l'objet résultant, une règle ne pourra pas voir l'entrée supprimée. Un outil intégré peut examiner en plus le texte original ; il convient de le clarifier pour le processus d'importation concret.
Python offre, avec object_pairs_hook, un point de départ pour traiter les paires ordonnées d'un objet lors du décodage. Une petite fonction de contrôle personnalisée a permis, dans l'essai synthétique, de détecter les noms répétés et de rejeter l'importation. Il s'agissait d'un test séparé lors de la lecture, et non d'une validation par rapport au schéma Jonas. Aucune fonction de protection prête à l'emploi pour une intégration client réelle n'a été prouvée ou introduite.
La limite s'applique à l'intérieur d'un objet. Le même nom peut figurer une fois dans deux objets différents sans que la répétition décrite ne soit présente. L'orthographe doit également être prise en compte : un nom avec une représentation échappée peut correspondre, après décodage, au même nom qu'une chaîne de caractères écrite directement. Le simple comptage des zones de texte visibles ne remplace donc pas une vérification des noms décodés dans chaque objet.
Pour les donneurs d'ordres d'un import de données, la question concrète est la suivante : les noms répétés sont-ils détectés avant une éventuelle perte d'information, et que se passe-t-il alors ? Une notification de succès de la validation du schéma ne répond à cette question que si le processus d'importation comprend réellement ce contrôle supplémentaire. De plus, l'ordre de deux indications ne détermine pas quel rythme de nettoyage a été convenu.
Jonas Gebäudereinigung met déjà à disposition un schéma de données public pour les plans de nettoyage ainsi qu'un exemple synthétique. L'article décrit une question d'importation générale dans ce contexte d'application existant. Il ne signale ni une nouvelle version logicielle, ni une erreur Jonas observée, ni une modification mise en œuvre.
Ressource : https://xn--jonas-gebudereinigung-e2b.de/ressourcen/reinigungsplan-datenschema/
Bases techniques : RFC 8259, sections 4 et 8.3 ; documentation Python, json ; JSON Schema 2020-12, Core, section 4.2.
Sources : https://www.rfc-editor.org/info/rfc8259/ · https://docs.python.org/3/library/json.html · https://json-schema.org/draft/2020-12/json-schema-core
Auteur de l'entreprise : Jonas Gebäudereinigung. Créé avec l'aide de l'IA et vérifié à l'aide des sources indiquées ; aucune expertise humaine personnelle n'est revendiquée.
Contact presse : Assistance presse pour Jonas Gebäudereinigung
Alexanderstraße 101 B, 26121 Oldenburg, Allemagne
Téléphone : +49 441 24923021
E-mail : info@jonas-gebäudereinigung.de